Пакистанские энтузиасты обучили нейросеть обрабатывать архивные снимки книг на урду
Команда Ibteda Digital Library оцифровала около 1800 редких и вышедших из печати изданий, сделав более 526 тысяч разворотов. Для автоматизации обработки архивисты использовали результаты собственной многолетней работы в Photoshop.
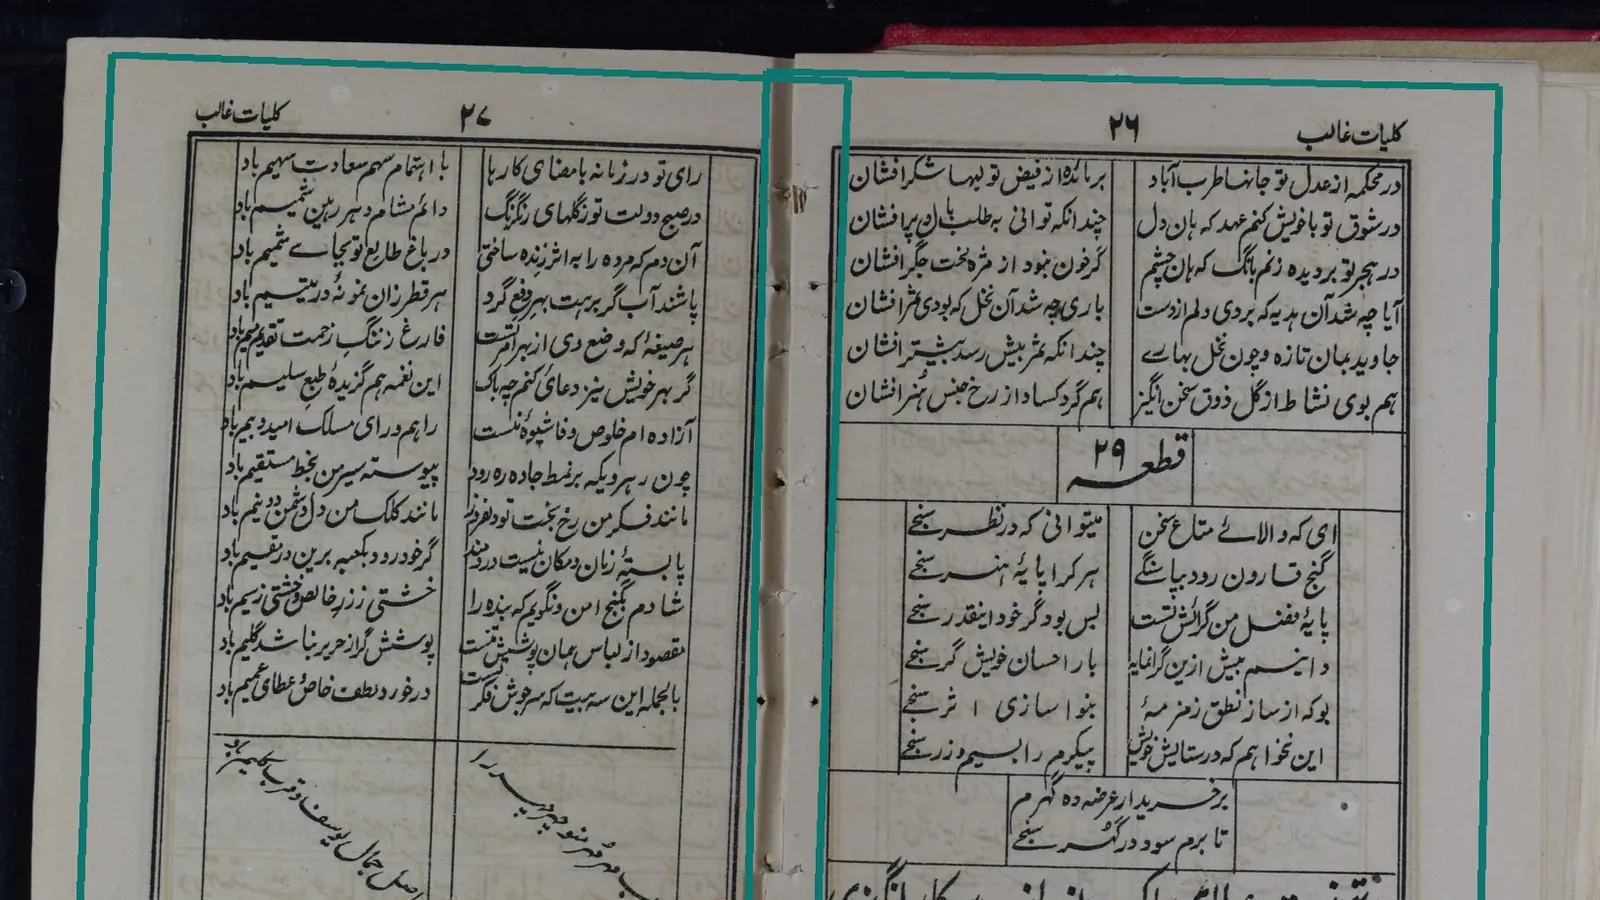
Создатели Ibteda Digital Library, частного проекта по сохранению книг на урду, разработали систему машинного обучения для обработки фотографий книжных разворотов. Она выросла из необходимости разобрать более 526 тысяч двухстраничных снимков, оставшихся после того, как команда прекратила проект в апреле 2026 года.
Инициатива началась примерно в 2015 году силами трёх друзей из Пакистана. Они покупали книги за собственные средства и снимали их на недорогие камеры Nikon: сначала использовали D5300, светодиодные лампы и стекло от копировального аппарата, прижимавшее страницы. На счётчике затвора Nikon D5300 накопилось 576 тысяч срабатываний, у D3300 — ещё 326 тысяч, то есть в сумме 902 тысячи.
Одной съёмки для архивной копии недостаточно: изображения нужно выравнивать, обрезать с одинаковыми полями, исправлять перспективу, отделять разворот в корешке и очищать от дефектов. Универсальные правила для этого не подошли: толщина книг, компоновка страниц и другие особенности менялись от издания к изданию. Особенно сложной стала работа с рукописными материалами и старыми литографиями, а также с письмом урду, где мелкие точки, диакритические знаки и другие детали легко спутать с шумом или загрязнениями на снимке.
Первые попытки автоматизации на базе стандартных методов компьютерного зрения не дали стабильного результата. Тогда один из участников проекта использовал пары исходных и вручную обработанных в Photoshop изображений: готовые страницы стали разметкой для обучения нейросети. Система учится определять параметры преобразования перспективы, ориентируясь на уже отредактированные примеры.
Автоматизация всё равно не стала полностью универсальной. Для нового издания требуется вручную подготовить десять калибровочных обрезок, а поля для кадрирования выбираются отдельно для каждой книги. По наблюдению автора разработки, увеличение модели и добавление большего числа обучающих примеров в отдельных случаях даже ухудшали точность, поскольку настройки обработки не складывались в единый шаблон.
Цифровая коллекция хранится в ZFS-пуле с манифестами BLAKE3. Материалы Ibteda Digital Library, включая оцифрованные тексты, доступны через Internet Archive.