NVIDIA представила память NVHBM для будущих ИИ-ускорителей
Новая архитектура переносит контроллер памяти в базовый кристалл HBM. NVIDIA заявляет, что это даст до 30% больше пропускной способности и сократит энергопотребление памяти до 15% по сравнению с HBM4E.
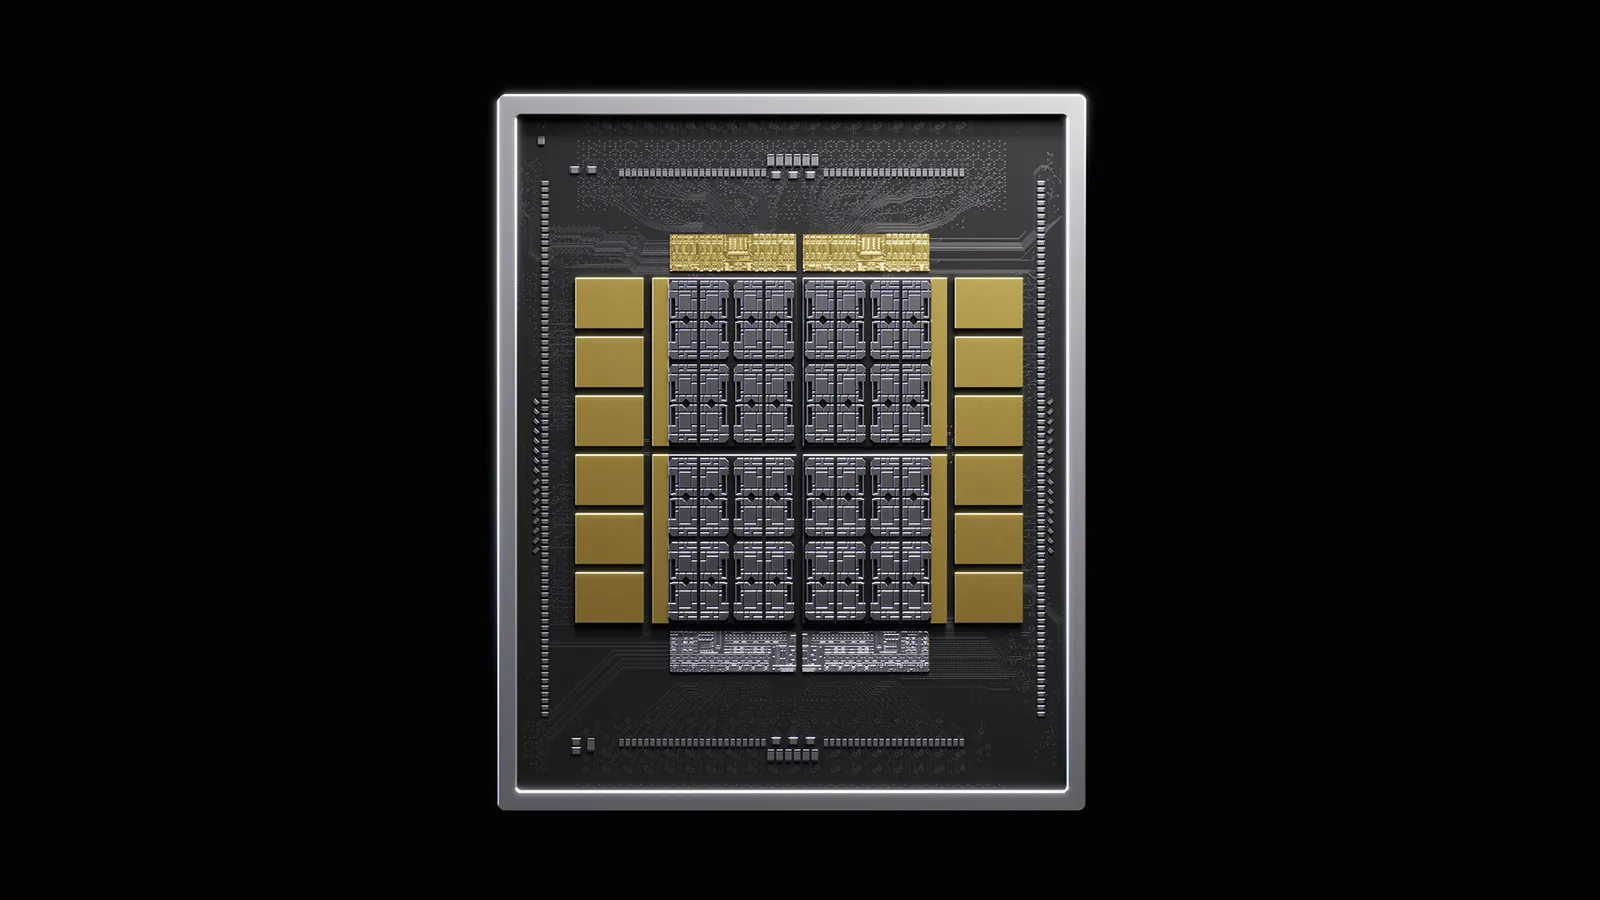
NVIDIA анонсировала NVHBM — собственную архитектуру высокоскоростной памяти для будущих ИИ-ускорителей. Её ключевое отличие от обычных решений HBM состоит в размещении контроллера памяти не в самом XPU, а в базовом кристалле стека HBM.
По оценке NVIDIA, такой подход обеспечит до 30% более высокую пропускную способность памяти относительно стандартной HBM4E и снизит энергопотребление HBM до 15%. Компания также говорит, что перенос контроллера высвобождает на основном вычислительном кристалле до 25% площади, которую можно использовать для дополнительных вычислительных блоков.
В NVIDIA утверждают, что по сравнению со стандартом JEDEC HBM4E новая схема сокращает площадь, необходимую для PHY-интерфейса и сопутствующих компонентов, на величину до 67%. Более узкий интерфейс должен также упростить разводку интерпозера и дать до 80% больше полезной площади кремния в компоновке.
NVHBM создаётся совместно с Annapurna Labs, подразделением Amazon. Одним из первых партнёров технологии станет сама Annapurna Labs: она планирует сочетать NVHBM с масштабируемой архитектурой NVLink для ИИ-нагрузок. Следующие поколения AWS Trainium, начиная с Trainium4, должны использовать NVLink Fusion для соединения GPU NVIDIA и чипов Amazon в общей стоечной архитектуре.
NVIDIA намерена предложить унифицированную реализацию NVHBM нескольким поставщикам памяти. По замыслу компании, это должно сократить усилия производителей ускорителей при интеграции и квалификации памяти от разных поставщиков.