Google представила Gemini 3.5 Transcribe для «чистой» расшифровки речи
Новая модель преобразует аудио в отформатированный текст, умеет убирать слова-паразиты и учитывать пользовательский словарь. Для разработчиков она доступна в публичной предварительной версии Gemini API.
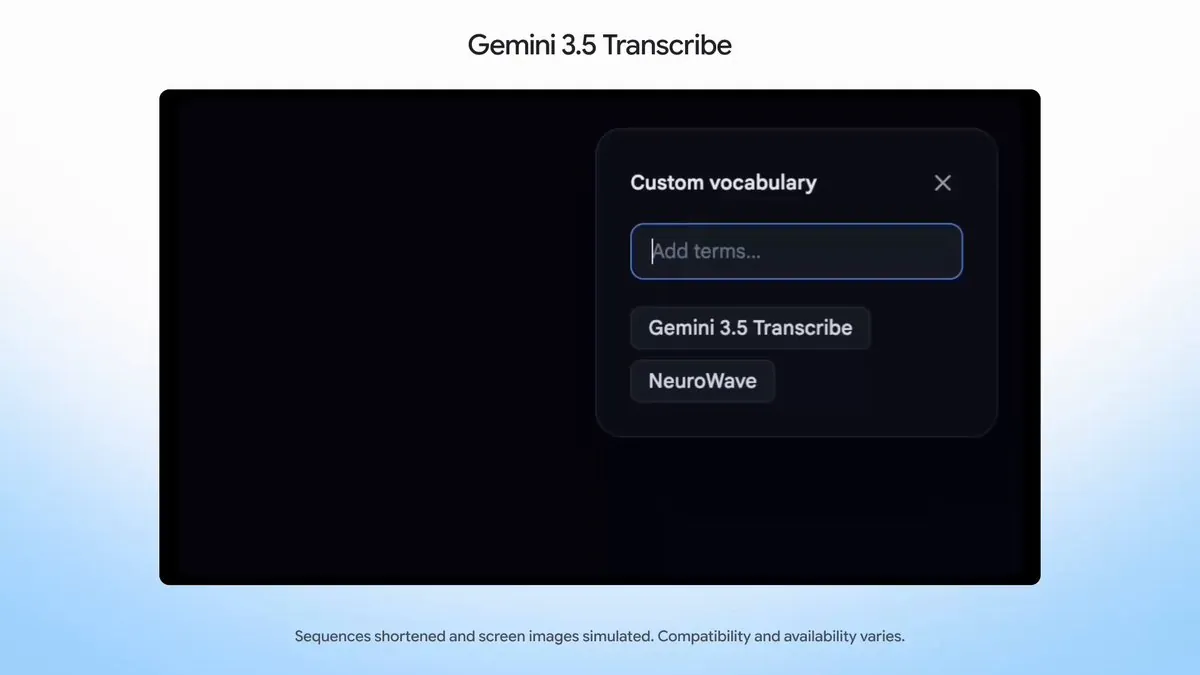
Google представила Gemini 3.5 Transcribe — модель распознавания речи, которая должна не просто записывать сказанное, но и приводить результат к более готовому виду. Она может удалять из расшифровки «эм», «э-э» и другие речевые запинки, а также учитывать исправления, которые человек вносит по ходу фразы.
По заявлению Google DeepMind, модель превращает необработанное аудио в точный, отформатированный текст и рассчитана на работу с фоновым шумом, специальной терминологией и неидеальной, спонтанной речью. Пользователь может передать ей собственный словарь — например, с необычными написаниями или профессиональным жаргоном. Это должно сократить число ручных исправлений.
Gemini 3.5 Transcribe поддерживает более 85 языков. При обработке заранее записанного аудио модель может разделять реплики до трёх собеседников и добавлять временные метки на уровне отдельных слов.
Для разработчиков Google открыла публичную предварительную версию модели в Gemini API через AI Studio и Gemini Enterprise Agent Platform. В режиме реального времени модель gemini-3.5-transcribe-live работает через Live API и обеспечивает двустороннюю потоковую передачу с задержкой менее секунды. Для записей встреч, звонков и других файлов доступна модель gemini-3.5-transcribe через Interactions API.
Как сообщает The Verge со ссылкой на Google, развёртывание также начинается для англоязычных пользователей приложения Gemini на macOS и функции диктовки Rambler на Android в отдельных странах и языках; поддержку Chrome компания обещает добавить позднее. По данным Ars Technica, Google оценивает скорость подготовки финальной расшифровки примерно на 70% выше, чем у предыдущей системы Chirp 3, а частоту ошибок при распознавании речи — в 5,5% против 7,32% у Chirp 3.
При этом обработка не ограничивается дословной записью: модель может менять формулировки, удаляя запинки и учитывая самоисправления. Поэтому такой результат удобнее для заметок и голосового ввода, но не обязательно подойдёт там, где нужна буквальная стенограмма.